IOI 2025 — Day 2

Bộ đề bài

# Bài tập Điểm Thời gian: Giới hạn bộ nhớ
1 IOI 2025 — Festival 100 (p) 1.0s 1G
2 IOI 2025 — Migrations 100 (p) 1.0s 1G
3 IOI 2025 — Obstacles for a Llama 100 (p) 2.0s 1G

1. IOI 2025 — Festival

Điểm: 100 (p) Thời gian: 1.0s Bộ nhớ: 1G Input: bàn phím Output: màn hình

Nayra đang tham dự một lễ hội và chơi một trò chơi mà giải thưởng lớn là một chuyến du lịch đến Laguna Colorada. Trò chơi gồm việc dùng các đồng xu (token) để mua các phiếu thưởng (coupon). Việc mua một phiếu thưởng có thể đem lại thêm xu. Mục tiêu là thu được càng nhiều phiếu thưởng càng tốt.

Cô bắt đầu trò chơi với \(A\) đồng xu. Có \(N\) phiếu thưởng, được đánh số từ \(0\) đến \(N-1\). Để mua phiếu thưởng \(i\) (\(0 \le i < N\)), Nayra phải trả \(P[i]\) đồng xu (và cô phải có ít nhất \(P[i]\) đồng xu trước khi mua). Mỗi phiếu thưởng chỉ có thể được mua tối đa một lần.

Hơn nữa, mỗi phiếu thưởng \(i\) (\(0 \le i < N\)) được gán một loại, ký hiệu là \(T[i]\), là một số nguyên từ \(1\) đến \(4\). Sau khi Nayra mua phiếu thưởng \(i\), số đồng xu còn lại của cô sẽ được nhân với \(T[i]\). Cụ thể, nếu tại một thời điểm nào đó trong trò chơi cô có \(X\) đồng xu và mua phiếu thưởng \(i\) (yêu cầu \(X \ge P[i]\)), thì sau khi mua cô sẽ có \((X - P[i]) \cdot T[i]\) đồng xu.

Nhiệm vụ của bạn là xác định Nayra nên mua những phiếu thưởng nào và theo thứ tự ra sao, để tối đa hóa tổng số phiếu thưởng cô có được vào cuối trò chơi. Nếu có nhiều hơn một dãy mua đạt được kết quả tối đa, bạn có thể đưa ra một dãy bất kỳ trong số đó.

Chi tiết cài đặt

Bạn cần cài đặt thủ tục sau, được khai báo trong festival.h:

C++
std::vector<int> max_coupons(int A, std::vector<int> P, std::vector<int> T)
  • \(A\): số đồng xu ban đầu của Nayra.
  • \(P\): mảng độ dài \(N\) chứa giá của các phiếu thưởng.
  • \(T\): mảng độ dài \(N\) chứa loại của các phiếu thưởng.
  • Thủ tục này được gọi đúng một lần cho mỗi test case.

Thủ tục cần trả về một mảng \(R\), mô tả các phiếu thưởng mà Nayra mua như sau:

  • Độ dài của \(R\) phải bằng số phiếu thưởng tối đa mà cô có thể mua.
  • Các phần tử của mảng là chỉ số của các phiếu thưởng cô nên mua, theo thứ tự thời gian. Nghĩa là, cô mua phiếu thưởng \(R[0]\) đầu tiên, sau đó là \(R[1]\), và cứ thế tiếp tục.
  • Tất cả các phần tử của \(R\) phải khác nhau.

Nếu không thể mua được phiếu thưởng nào, \(R\) phải là một mảng rỗng.

Ràng buộc

  • \(1 \le N \le 200\,000\)
  • \(1 \le A \le 10^9\)
  • \(1 \le P[i] \le 10^9\) với mọi \(i\) thỏa \(0 \le i < N\).
  • \(1 \le T[i] \le 4\) với mọi \(i\) thỏa \(0 \le i < N\).

Phân nhóm

  • Subtask 1 (5 điểm): \(T[i] = 1\) với mọi \(i\) thỏa \(0 \le i < N\).
  • Subtask 2 (7 điểm): \(N \le 3000\); \(T[i] \le 2\) với mọi \(i\) thỏa \(0 \le i < N\).
  • Subtask 3 (12 điểm): \(T[i] \le 2\) với mọi \(i\) thỏa \(0 \le i < N\).
  • Subtask 4 (15 điểm): \(N \le 70\).
  • Subtask 5 (27 điểm): Nayra có thể mua tất cả \(N\) phiếu thưởng (theo một thứ tự nào đó).
  • Subtask 6 (16 điểm): \((A - P[i]) \cdot T[i] < A\) với mọi \(i\) thỏa \(0 \le i < N\).
  • Subtask 7 (18 điểm): Không có ràng buộc bổ sung.

Ví dụ

Ví dụ 1. Xét lời gọi sau:

max_coupons(13, [4, 500, 8, 14], [1, 3, 3, 4])

Ban đầu Nayra có \(A = 13\) đồng xu. Cô có thể mua \(3\) phiếu thưởng theo thứ tự sau:

Phiếu mua Giá phiếu Loại phiếu Số xu sau khi mua
\(2\) \(8\) \(3\) \((13 - 8) \cdot 3 = 15\)
\(3\) \(14\) \(4\) \((15 - 14) \cdot 4 = 4\)
\(0\) \(4\) \(1\) \((4 - 4) \cdot 1 = 0\)

Trong ví dụ này, Nayra không thể mua nhiều hơn \(3\) phiếu thưởng, và dãy mua được mô tả ở trên là cách duy nhất để cô mua được \(3\) phiếu. Do đó, thủ tục cần trả về \([2, 3, 0]\).

Ví dụ 2. Xét lời gọi sau:

max_coupons(9, [6, 5], [2, 3])

Trong ví dụ này, Nayra có thể mua cả hai phiếu thưởng theo thứ tự bất kỳ. Do đó, thủ tục cần trả về hoặc \([0, 1]\) hoặc \([1, 0]\).

Ví dụ 3. Xét lời gọi sau:

max_coupons(1, [2, 5, 7], [4, 3, 1])

Trong ví dụ này, Nayra chỉ có một đồng xu, không đủ để mua bất kỳ phiếu thưởng nào. Do đó, thủ tục cần trả về \([\,]\) (một mảng rỗng).

Chương trình chấm mẫu

Định dạng đầu vào:

N A
P[0] T[0]
P[1] T[1]
...
P[N-1] T[N-1]

Định dạng đầu ra:

S
R[0] R[1] ... R[S-1]

Ở đây, \(S\) là độ dài của mảng \(R\) được trả về bởi max_coupons.

Test 1

Input
4 13
4 1
500 3
8 3
14 4
Output
3
2 3 0
Ghi chú

Mua phiếu \(2\) (giá \(8\), loại \(3\)): còn \((13-8) \cdot 3 = 15\) xu. Mua phiếu \(3\) (giá \(14\), loại \(4\)): còn \((15-14) \cdot 4 = 4\) xu. Mua phiếu \(0\) (giá \(4\), loại \(1\)): còn \((4-4) \cdot 1 = 0\) xu. Tổng cộng mua được \(3\) phiếu, đó là số phiếu tối đa.

Test 2

Input
2 9
6 2
5 3
Output
2
0 1
Ghi chú

Có thể mua cả hai phiếu theo thứ tự bất kỳ; ví dụ trên trả về \([0, 1]\), nhưng \([1, 0]\) cũng được chấp nhận.

Test 3

Input
3 1
2 4
5 3
7 1
Output
0
Ghi chú

Nayra chỉ có \(1\) đồng xu, không đủ để mua bất kỳ phiếu thưởng nào (phiếu rẻ nhất giá \(2\)). Do đó kết quả là một mảng rỗng.

2. IOI 2025 — Migrations

Điểm: 100 (p) Thời gian: 1.0s Bộ nhớ: 1G Input: bàn phím Output: màn hình

Bảo tàng Lịch sử Tự nhiên đang nghiên cứu các kiểu di cư của khủng long ở Bolivia. Các nhà cổ sinh vật học đã phát hiện ra dấu chân khủng long tại \(N\) địa điểm khác nhau, được đánh số từ \(0\) đến \(N-1\) theo thứ tự tuổi giảm dần: địa điểm \(0\) chứa các dấu chân cổ nhất, còn địa điểm \(N-1\) chứa các dấu chân trẻ nhất.

Khủng long đã di cư đến mỗi địa điểm (trừ địa điểm \(0\)) từ một địa điểm cổ hơn nào đó. Với mọi địa điểm \(i\) thỏa mãn \(1 \le i \le N-1\), tồn tại đúng một địa điểm cổ hơn \(P[i]\) (với \(P[i] < i\)) sao cho có một số khủng long đã di cư trực tiếp từ địa điểm \(P[i]\) sang địa điểm \(i\). Một địa điểm cổ có thể là nguồn di cư đến nhiều địa điểm trẻ hơn.

Các nhà cổ sinh vật học mô hình hóa mỗi cuộc di cư như là một cạnh vô hướng giữa địa điểm \(i\) và \(P[i]\). Lưu ý rằng với hai địa điểm phân biệt \(x\) và \(y\) bất kỳ, ta luôn có thể đi từ \(x\) đến \(y\) bằng cách đi qua một dãy các cạnh. Khoảng cách giữa hai địa điểm \(x\) và \(y\) được định nghĩa là số cạnh ít nhất cần đi để đi từ \(x\) đến \(y\).

Ví dụ, với \(N = 5\) và \(P[1] = 0\), \(P[2] = 1\), \(P[3] = 2\), \(P[4] = 2\), ta có thể đi từ địa điểm \(3\) đến địa điểm \(4\) qua \(2\) cạnh, vậy khoảng cách giữa chúng là \(2\).
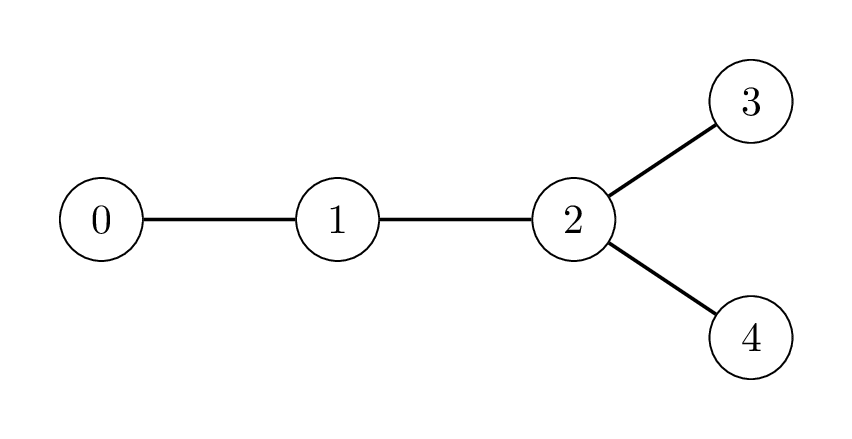
Bảo tàng muốn xác định một cặp địa điểm có khoảng cách lớn nhất có thể (tức là đường kính của cây). Lưu ý rằng cặp này không nhất thiết duy nhất: chẳng hạn trong ví dụ trên, cả hai cặp \((0, 3)\) và \((0, 4)\) đều có khoảng cách \(3\) là lớn nhất. Trong các trường hợp như vậy, bất kỳ cặp nào đạt khoảng cách lớn nhất đều được xem là hợp lệ.

Ban đầu, các giá trị \(P[i]\) chưa được biết. Bảo tàng cử một nhóm nghiên cứu lần lượt đến thăm các địa điểm \(1, 2, \ldots, N-1\). Khi đến địa điểm \(i\) (\(1 \le i \le N-1\)), nhóm nghiên cứu thực hiện cả hai hành động sau:

  • Xác định giá trị \(P[i]\), tức là nguồn của cuộc di cư đến địa điểm \(i\).
  • Quyết định gửi đúng một thông điệp về Bảo tàng hoặc không gửi thông điệp nào từ địa điểm này, dựa trên thông tin đã thu thập được trước đó.

Các thông điệp được truyền qua một hệ thống vệ tinh đắt tiền, nên mỗi thông điệp phải là một số nguyên trong khoảng từ \(1\) đến \(20\,000\). Ngoài ra, nhóm nghiên cứu chỉ được phép gửi tối đa \(50\) thông điệp trong toàn bộ quá trình.

Nhiệm vụ của bạn là cài đặt một chiến lược, qua đó:

  • Nhóm nghiên cứu chọn các địa điểm để gửi thông điệp, cùng với giá trị của mỗi thông điệp.
  • Bảo tàng có thể xác định một cặp địa điểm có khoảng cách lớn nhất, chỉ dựa trên các thông điệp nhận được từ mỗi địa điểm và biết các thông điệp được gửi từ địa điểm nào.

Việc gửi số lớn qua vệ tinh tốn chi phí cao. Điểm số của bạn sẽ phụ thuộc vào cả số nguyên lớn nhất được gửi và tổng số thông điệp được truyền đi.

Chi tiết cài đặt

Đây là một bài toán giao tiếp gồm hai pha. Chương trình của bạn sẽ được chạy đúng hai lần, và không có dữ liệu nào được lưu giữa hai lần chạy (các biến toàn cục, file, v.v., đều bị xóa). Hai pha chỉ liên lạc với nhau qua mảng \(S\).

Bạn cần cài đặt hai hàm sau trong file migrations.h:

Pha 1 (mã hóa) — dành cho nhóm nghiên cứu:

C++
int send_message(int N, int i, int Pi)
  • \(N\): số địa điểm có dấu chân.
  • \(i\): chỉ số của địa điểm nhóm nghiên cứu đang đến thăm.
  • \(Pi\): giá trị \(P[i]\).
  • Hàm này được gọi \(N-1\) lần với mỗi test, theo thứ tự \(i = 1, 2, \ldots, N-1\).

Hàm này phải trả về \(S[i]\) chỉ định hành động của nhóm nghiên cứu tại địa điểm \(i\):

  • \(S[i] = 0\): nhóm quyết định không gửi thông điệp từ địa điểm \(i\).
  • \(1 \le S[i] \le 20\,000\): nhóm gửi số nguyên \(S[i]\) làm thông điệp từ địa điểm \(i\).

Pha 2 (giải mã) — dành cho Bảo tàng:

C++
std::pair<int,int> longest_path(std::vector<int> S)
  • \(S\): mảng có độ dài \(N\) sao cho:
  • \(S[0] = 0\).
  • Với mỗi \(1 \le i \le N-1\), \(S[i]\) là giá trị mà send_message(N, i, Pi) đã trả về.
  • Hàm này được gọi đúng một lần cho mỗi test.

Hàm này phải trả về cặp địa điểm \((U, V)\) có khoảng cách lớn nhất.

Trong quá trình chấm thực tế, một chương trình gọi các hàm trên được chạy đúng hai lần.

  • Trong lần chạy thứ nhất:
  • send_message được gọi đúng \(N-1\) lần.
  • Chương trình của bạn có thể lưu trữ và giữ lại thông tin giữa các lần gọi liên tiếp (trong cùng pha 1).
  • Các giá trị trả về (mảng \(S\)) được hệ thống chấm lưu lại.
  • Trong một số trường hợp, hành vi của trình chấm là thích nghi (adaptive). Điều này có nghĩa là giá trị \(P[i]\) trong một lần gọi send_message có thể phụ thuộc vào các hành động của nhóm nghiên cứu trong các lần gọi trước đó.
  • Trong lần chạy thứ hai:
  • longest_path được gọi đúng một lần. Thông tin duy nhất mà longest_path có được từ lần chạy thứ nhất là mảng \(S\).

Ràng buộc

  • \(N = 10\,000\)
  • \(0 \le P[i] < i\) với mỗi \(i\) thỏa \(1 \le i \le N-1\).

Phân nhóm

  • Subtask 1 (30 điểm): Địa điểm \(0\) và một địa điểm khác nào đó có khoảng cách lớn nhất trong tất cả các cặp địa điểm.
  • Subtask 2 (70 điểm): Không có ràng buộc bổ sung.

Gọi \(Z\) là số nguyên lớn nhất xuất hiện trong mảng \(S\), và \(M\) là số thông điệp (số phần tử khác \(0\)) mà nhóm nghiên cứu đã gửi.

Trong bất kỳ test nào, nếu có ít nhất một trong các điều kiện sau xảy ra, điểm của bạn cho test đó sẽ là \(0\) (hiển thị Output isn't correct trong CMS):

  • Có ít nhất một phần tử trong \(S\) không hợp lệ.
  • \(Z > 20\,000\) hoặc \(M > 50\).
  • Giá trị trả về của longest_path không đúng.

Ngược lại, điểm của bạn cho subtask 1 được tính như sau:

Điều kiện Điểm
\(9\,998 \le Z \le 20\,000\) \(10\)
\(102 \le Z \le 9\,997\) \(16\)
\(5 \le Z \le 101\) \(23\)
\(Z \le 4\) \(30\)

Điểm của bạn cho subtask 2 được tính như sau:

Điều kiện Điểm
\(5 \le Z \le 20\,000\) và \(M \le 50\) \(35 - 25 \log_{4000}\left(\dfrac{Z}{5}\right)\)
\(Z \le 4\) và \(32 \le M \le 50\) \(40\)
\(Z \le 4\) và \(9 \le M \le 31\) \(70 - 30 \log_{4}\left(\dfrac{M}{8}\right)\)
\(Z \le 4\) và \(M \le 8\) \(70\)

Ví dụ

Giả sử \(N = 10\,000\). Xét tình huống \(P[1] = 0\), \(P[2] = 1\), \(P[3] = 2\), \(P[4] = 2\), và \(P[i] = 1\) với mọi \(i > 4\).
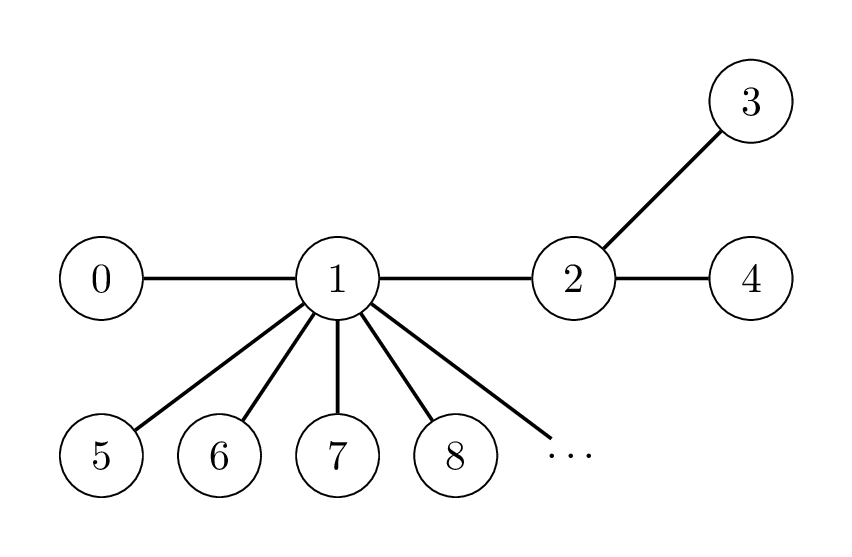
Giả sử chiến lược của nhóm nghiên cứu là: bất cứ khi nào cặp \((U, V)\) có khoảng cách lớn nhất thay đổi sau một lần gọi send_message, nhóm gửi thông điệp \(10 \cdot V + U\).

Ban đầu, cặp có khoảng cách lớn nhất là \((U, V) = (0, 0)\). Xét dãy lời gọi sau trong lần chạy thứ nhất:

Lời gọi hàm \((U, V)\) Giá trị trả về \(S[i]\)
send_message(10000, 1, 0) \((0, 1)\) \(10\)
send_message(10000, 2, 1) \((0, 2)\) \(20\)
send_message(10000, 3, 2) \((0, 3)\) \(30\)
send_message(10000, 4, 2) \((0, 3)\) \(0\)

Lưu ý rằng trong tất cả các lời gọi còn lại, \(P[i] = 1\). Điều này có nghĩa là cặp có khoảng cách lớn nhất không thay đổi, và nhóm không gửi thêm thông điệp nào nữa.

Sau đó, trong lần chạy thứ hai, lời gọi sau được thực hiện:

C++
longest_path([0, 10, 20, 30, 0, ...])

Bảo tàng đọc thông điệp cuối cùng mà nhóm nghiên cứu đã gửi, đó là \(S[3] = 30\), và suy ra rằng \((0, 3)\) là cặp địa điểm có khoảng cách lớn nhất. Do đó, lời gọi này trả về \((0, 3)\).

Lưu ý rằng cách tiếp cận này không phải lúc nào cũng giúp Bảo tàng xác định đúng cặp có khoảng cách lớn nhất.

Sample input:

5
0 1 2 2

Sample output:

10 20 30 0
0 3

Chấm điểm

Trình chấm mẫu gọi cả send_message và longest_path trong cùng một lần chạy, khác với trình chấm thực tế.

Định dạng input:

N
P[1] P[2] ... P[N-1]

Định dạng output:

S[1] S[2] ... S[N-1]
U V

Bạn có thể sử dụng trình chấm mẫu với giá trị \(N\) tùy ý.
3. IOI 2025 — Obstacles for a Llama

Điểm: 100 (p) Thời gian: 2.0s Bộ nhớ: 1G Input: bàn phím Output: màn hình

Một con lạc đà không bướu (llama) muốn đi xuyên qua Cao nguyên Andes. Nó có một bản đồ của cao nguyên dưới dạng một lưới gồm \(N \times M\) ô vuông. Các hàng của bản đồ được đánh số từ \(0\) đến \(N-1\) từ trên xuống dưới, và các cột được đánh số từ \(0\) đến \(M-1\) từ trái sang phải. Ô của bản đồ ở hàng \(i\) và cột \(j\) (với \(0 \le i < N, 0 \le j < M\)) được ký hiệu là \((i, j)\).

Lạc đà đã nghiên cứu khí hậu của cao nguyên và phát hiện ra rằng tất cả các ô trong cùng một hàng của bản đồ có cùng nhiệt độ, và tất cả các ô trong cùng một cột của bản đồ có cùng độ ẩm. Lạc đà đưa cho bạn hai mảng số nguyên \(T\) và \(H\) có độ dài lần lượt là \(N\) và \(M\). Ở đây, \(T[i]\) (với \(0 \le i < N\)) chỉ nhiệt độ của các ô ở hàng \(i\), và \(H[j]\) (với \(0 \le j < M\)) chỉ độ ẩm của các ô ở cột \(j\).

Lạc đà cũng đã nghiên cứu thảm thực vật của cao nguyên và nhận thấy rằng một ô \((i, j)\) là không có thực vật khi và chỉ khi nhiệt độ của nó lớn hơn độ ẩm của nó, tức là \(T[i] > H[j]\).

Lạc đà chỉ có thể di chuyển qua cao nguyên bằng cách đi theo các đường đi hợp lệ. Một đường đi hợp lệ là một dãy các ô phân biệt thoả mãn các điều kiện sau:

  • Mỗi cặp ô liên tiếp trên đường đi có chung một cạnh.
  • Tất cả các ô trên đường đi đều không có thực vật.

Nhiệm vụ của bạn là trả lời \(Q\) câu hỏi. Với mỗi câu hỏi, bạn được cho bốn số nguyên: \(L, R, S\) và \(D\). Bạn phải xác định xem có tồn tại một đường đi hợp lệ thoả mãn các điều kiện sau hay không:

  • Đường đi bắt đầu tại ô \((0, S)\) và kết thúc tại ô \((0, D)\).
  • Tất cả các ô trên đường đi đều nằm trong các cột từ \(L\) đến \(R\), bao gồm cả hai đầu mút.

Đảm bảo rằng cả hai ô \((0, S)\) và \((0, D)\) đều không có thực vật.

Bạn cần cài đặt hai hàm trong tệp obstacles.h để tương tác với bộ chấm.

Hàm đầu tiên cần cài đặt là:

void initialize(std::vector<int> T, std::vector<int> H)
  • \(T\): một mảng có độ dài \(N\) chỉ nhiệt độ của mỗi hàng.
  • \(H\): một mảng có độ dài \(M\) chỉ độ ẩm của mỗi cột.
  • Hàm này được gọi đúng một lần cho mỗi test, trước bất kỳ lệnh gọi nào tới can_reach.

Hàm thứ hai cần cài đặt là:

bool can_reach(int L, int R, int S, int D)
  • \(L, R, S, D\): các số nguyên mô tả một câu hỏi.
  • Hàm này được gọi \(Q\) lần cho mỗi test.

Hàm này phải trả về true khi và chỉ khi tồn tại một đường đi hợp lệ từ ô \((0, S)\) đến ô \((0, D)\), sao cho tất cả các ô trên đường đi đều nằm trong các cột từ \(L\) đến \(R\), bao gồm cả hai đầu mút.

Chi tiết cài đặt

Bạn không được cài đặt hàm main trong tệp giải. Cần cài đặt hai hàm initialize và can_reach như mô tả ở trên trong tệp obstacles.h.

Ràng buộc

  • \(1 \le N, M, Q \le 200\,000\)
  • \(0 \le T[i] \le 10^9\) với mỗi \(i\) thoả mãn \(0 \le i < N\).
  • \(0 \le H[j] \le 10^9\) với mỗi \(j\) thoả mãn \(0 \le j < M\).
  • \(0 \le L \le R < M\)
  • \(L \le S \le R\)
  • \(L \le D \le R\)
  • Cả hai ô \((0, S)\) và \((0, D)\) đều không có thực vật.

Phân nhóm

  • Subtask 1 (10 điểm): \(L = 0, R = M - 1\) với mỗi câu hỏi. \(N = 1\).
  • Subtask 2 (14 điểm): \(L = 0, R = M - 1\) với mỗi câu hỏi. \(T[i-1] \le T[i]\) với mỗi \(i\) thoả mãn \(1 \le i < N\).
  • Subtask 3 (13 điểm): \(L = 0, R = M - 1\) với mỗi câu hỏi. \(N = 3\) và \(T = [2, 1, 3]\).
  • Subtask 4 (21 điểm): \(L = 0, R = M - 1\) với mỗi câu hỏi. \(Q \le 10\).
  • Subtask 5 (25 điểm): \(L = 0, R = M - 1\) với mỗi câu hỏi.
  • Subtask 6 (17 điểm): Không có ràng buộc bổ sung.

Ví dụ

Xét lệnh gọi sau:

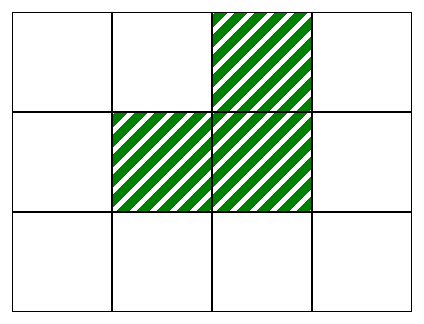
initialize([2, 1, 3], [0, 1, 2, 0])

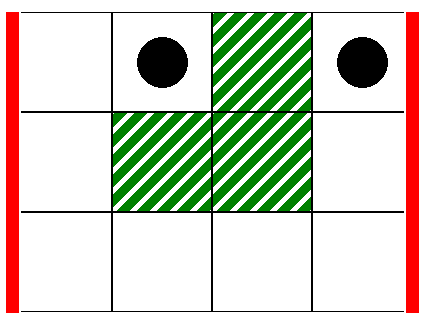
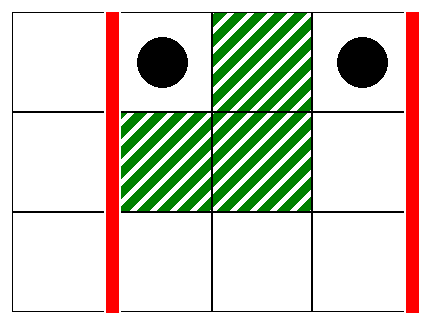
Lệnh gọi này tương ứng với bản đồ trong đó các ô không có thực vật (màu trắng) và các ô có thực vật (màu xanh) như sau: với \(N = 3\) hàng và \(M = 4\) cột, các ô \((0, 2), (1, 1), (1, 2)\) là có thực vật, các ô còn lại đều không có thực vật.

Ở câu hỏi đầu tiên, xét lệnh gọi:

can_reach(0, 3, 1, 3)

Trong tình huống này, các cột được giới hạn trong khoảng từ \(L = 0\) đến \(R = 3\). Lạc đà có thể đi từ ô \((0, 1)\) đến ô \((0, 3)\) thông qua đường đi hợp lệ sau:

\[ (0, 1), (0, 0), (1, 0), (2, 0), (2, 1), (2, 2), (2, 3), (1, 3), (0, 3) \]

Do đó, lệnh gọi này phải trả về true.

Ở câu hỏi thứ hai, xét lệnh gọi:

can_reach(1, 3, 1, 3)

Trong tình huống này, không tồn tại đường đi hợp lệ từ ô \((0, 1)\) đến ô \((0, 3)\) sao cho tất cả các ô trên đường đi đều nằm trong các cột từ \(1\) đến \(3\), bao gồm cả hai đầu mút. Do đó, lệnh gọi này phải trả về false.

Ví dụ 1

Dữ liệu vào
3 4
2 1 3
0 1 2 0
2
0 3 1 3
1 3 1 3
Kết quả ra
1
0
Giải thích

Trong test này, \(N = 3, M = 4\), mảng nhiệt độ \(T = [2, 1, 3]\) và mảng độ ẩm \(H = [0, 1, 2, 0]\). Có \(Q = 2\) câu hỏi.

Câu hỏi đầu tiên có \(L = 0, R = 3, S = 1, D = 3\): tồn tại đường đi hợp lệ từ \((0, 1)\) đến \((0, 3)\) trong toàn bộ lưới, nên đáp án là 1 (true).

Câu hỏi thứ hai có \(L = 1, R = 3, S = 1, D = 3\): khi giới hạn các cột trong khoảng \([1, 3]\), không tồn tại đường đi hợp lệ từ \((0, 1)\) đến \((0, 3)\), nên đáp án là 0 (false).

Chấm điểm

Định dạng đầu vào của bộ chấm mẫu:

N M
T[0] T[1] ... T[N-1]
H[0] H[1] ... H[M-1]
Q
L[0] R[0] S[0] D[0]
L[1] R[1] S[1] D[1]
...
L[Q-1] R[Q-1] S[Q-1] D[Q-1]

Ở đây, \(L[k], R[k], S[k]\) và \(D[k]\) (với \(0 \le k < Q\)) chỉ các tham số cho mỗi lệnh gọi tới can_reach.

Định dạng đầu ra của bộ chấm mẫu:

A[0]
A[1]
...
A[Q-1]

Ở đây, \(A[k]\) (với \(0 \le k < Q\)) bằng \(1\) nếu lệnh gọi can_reach(L[k], R[k], S[k], D[k]) trả về true, và bằng \(0\) trong trường hợp ngược lại.